16GB 그래픽카드에서 구글 Gemma 4 12B는 여유 있게 돌아갑니다. RTX 5060 Ti 16GB로 직접 돌려 보니 VRAM은 약 8.6GB만 썼고, 글은 초당 약 44토큰으로 나왔습니다. 16GB 가운데 7GB 넘게 남는 셈입니다. 다만 '생각' 기능을 끄면 간단한 산수를 5번 모두 틀렸습니다.
이 글은 EVUELA AI LAB 에 올린 테스트 글을 줄인 요약입니다. 전체 측정값과 화면 영상은 원문에 있습니다: [RTX 5060 Ti 16GB] 16GB 그래픽카드로 Gemma 4 12B 돌려도 될까, 7GB가 남았다
이 숫자는 RTX 5060 Ti 16GB PC 한 대에서 직접 잰 것입니다. 프로그램은 LM Studio 0.4.25였고 설정은 기본값 그대로 뒀습니다. 모델 파일은 4비트로 줄인 QAT 판(7.15GB)이고, 잰 날은 2026년 9월 28일입니다.
VRAM은 얼마나 쓰나요?
한 번에 기억하는 양(컨텍스트)을 늘려 가며 쟀습니다.
| 컨텍스트 길이 | 모델이 쓴 VRAM | 16GB 중 남는 양 |
|---|---|---|
| 8,192 (기본값) | 약 8.6GB | 약 7.4GB |
| 32,768 | 약 9.0GB | 약 7.0GB |
| 131,072 | 약 10.6GB | 약 5.4GB |
이 표가 뜻하는 것: 컨텍스트를 기본값의 16배로 늘려도 2GB밖에 더 쓰지 않았습니다. 긴 문서를 넣을 일이 있어도 16GB 카드로 충분합니다. 가장 큰 262,144는 LM Studio가 메모리가 모자랄 것이라고 계산해 불러오기를 막았고, 실제로 들어가는지는 확인하지 못했습니다.
속도는 쓸 만한가요?
800자 글을 시켰을 때 초당 43.6~44.6토큰이었습니다. 글이 올라오는 속도는 읽기에 답답하지 않습니다. 기다린다고 느껴지는 부분은 답하기 전에 생각하는 시간입니다. 생각을 켠 상태에서는 800자 글을 다 받는 데 30~40초, 끄면 14~16초가 걸렸습니다.
같은 방법으로 잰 RTX 5090은 초당 약 144토큰이어서, 5060 Ti는 그 30% 정도입니다. 긴 글을 읽어 들일 때는 차이가 더 벌어집니다. 한국어 10만 자를 넣으면 답이 시작될 때까지 35초가 걸렸습니다.
'생각' 기능은 켜 둬야 하나요?
계산이나 논리가 들어가는 질문이라면 켜 두는 것이 맞습니다. 사과 개수를 나누는 산수 문제를 5번씩 물었습니다.
- 생각 켬(기본값): 5번 중 5번 정답. 답까지 평균 6.7초.
- 생각 끔: 5번 중 0번 정답. 0.5초 만에 답했지만 틀린 답이 매번 달랐습니다.
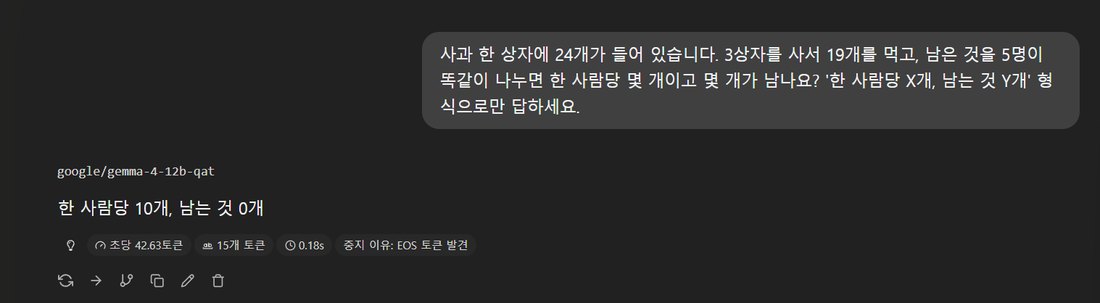
RTX 5090에서도 결과는 똑같았습니다. 정답률은 그래픽카드가 아니라 모델과 설정이 정합니다.
그래서 16GB로 써도 되나요?
- 대화, 요약, 이미지 설명 용도라면 충분합니다. 모델 전체가 GPU에 올라가고 메모리도 남습니다.
- 생각 기능은 켜 둡니다. 대신 답을 받기까지 몇 초에서 수십 초를 더 기다립니다.
- 아주 긴 문서를 자주 넣는다면 읽어 들이는 시간이 길어지는 점을 알고 써야 합니다.
이 요약에 없는 것
원문에는 테스트 PC의 전체 사양, LM Studio 기본 설정 화면 캡처, 회차별 속도 표, 없는 소설을 물었을 때의 답, 사진을 넣었을 때의 결과, RTX 5090과 나란히 놓은 비교가 있습니다. 이 글은 LM Studio로 잰 값입니다. 지금은 Unsloth Studio로 테스트하고 있고, 처음 시작하는 분을 위한 순서는 로컬 AI 시작하기 가이드에 정리했습니다.
'로컬 AI' 카테고리의 다른 글
| Hermes Agent 로컬 모델 연결, 자체 엔진과 Unsloth Studio 중 무엇이 빠를까: 91초와 123초 (RTX 5090, Qwen3.8 27B) (0) | 2026.10.10 |
|---|
